ChatGPTやGeminiに質問したとき、答えが返るまで「考えています」「Thinking」といった表示がしばらく続いた経験はありませんか。すぐ返ってくるときもあれば、やけに待たされるときもある。この差の正体が、各社が開発を進めている推論モデルです。
ところが調べてみると、出てくる解説はAPIの設定方法ばかりで、「自分の画面に出るあの表示は何なのか」「なぜ返事が遅いのか」には答えてくれません。そこが分からないままだと、モデル選びも設定もなんとなくで済ませることになります。
この記事では、推論モデルの仕組みと普通のモデルとの違い、使い分けの判断軸、そして自分のパソコンで動かす場合の考え方までをまとめます。引用と数値は2026年9月2日にOpenAI・Google・Anthropicの公式ドキュメント、Ollamaの公開ページ、および報道であらためて確認したものです。
- 推論モデルは「賢い上位版」ではなく、時間とトークンを払って精度を買うモードです。普段は即答型と自動切り替えに任せ、数学・プログラミング・長い分析のときだけ深く考えさせるのが現実的な使い方になります。
- 答える前に内部で「思考トークン」を作る。これは画面に出なくても出力トークンとして課金される(OpenAI・Google・Anthropicの公式ドキュメントで扱いが一致。2026年9月2日確認)
- 画面に表示される思考は要約であって、AIが実際にたどった思考そのものではない。要約が短くても、課金は生成された思考の全量が対象
- 深さの指定は各社とも自動判断が既定になりつつある。手動で刻むより、まず自動に任せるほうが扱いやすい
- 手元のパソコンでも動かせる。モデル本体のサイズ+思考の分の余裕がメモリ・VRAMに載るかが目安
推論モデル(Thinking)とは?答える前に「考える」AIのこと
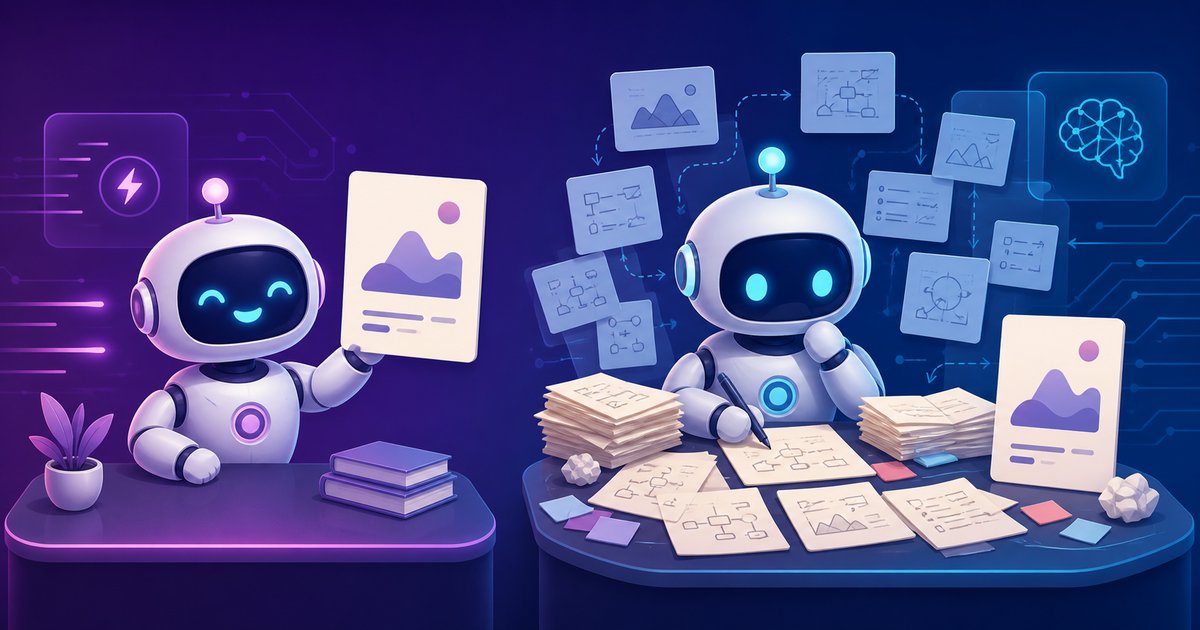
推論モデルとは、質問に対していきなり答えを書き始めるのではなく、内部で下書きのように考えてから答えを返すモデルのことです。英語ではreasoning model、サービスの画面上では「Thinking」と表示されることが多く、あの待ち時間はまさに考えている最中の時間にあたります。
まずは自分の画面から。「Thinking」という表示の正体
ITmediaは2026年3月18日の記事で、OpenAIがChatGPTのモデル選択を「Instant(日常的なチャット向け)」「Thinking(複雑な質問向け)」「Pro(最も複雑な質問向け)」の3系統に整理したと報じています。
同記事によれば、Plusプランで選べるのはこのうち前の2つです。このThinkingが、いま説明している推論モデルにあたります。
同記事はあわせて、設定メニューから「Thinkingへの自動切り替え」を有効にすると高速応答と高度な推論が状況に応じて切り替わること、Pro以上のプランではThinkingやPro利用時の推論の強度を調整できることも伝えています。
これは2026年3月時点で報じられた整理なので、お使いの画面では名称や並びが変わっている場合があります。
紛らわしい「推論」という言葉を先に整理する
ここでつまずきやすいのが言葉です。AIの世界で以前から使われてきた「推論(inference)」は、学習済みのモデルを動かして答えを出すこと全般を指します。普通のモデルで一問一答するのも、この意味では推論にあたります。
一方この記事で扱う「推論モデル(reasoning model)」は、答えを出す前に考える工程を内側に持ったモデルという意味です。同じ「推論」でも指すものが違うので、検索結果に技術寄りの記事が混ざったときは、どちらの話なのかを見分けてください。
中で何をしているのか:下書きしてから清書する人に近い
Anthropicが公開しているThinkingの解説ページは、一発で答えるモデルには「下書きも、確かめ直しも、途中での方針転換もない」と書いたうえで、思考が働いているときのClaudeの動きをこう説明しています。
問われている内容を自分の言葉で言い直し、いくつかのやり方を試し、途中の結果を確認し、うまくいかない道は捨てる。いきなり清書せず、手元で下書きを回してから提出しているわけです(2026年9月2日確認)。
OpenAIの開発者向けドキュメントも、推論モデルは応答を作る前に内部の推論トークンを使い、計画を立てたり別の選択肢を検討したりする、と説明しています。答えを書きながら考えるのではなく、書く前に考える。この順番の違いが、手数の多い問題で差になって出てきます。
| 比べる軸 | 普通のモデル(即答型) | 推論モデル(Thinking) |
|---|---|---|
| 答え方 | 質問を読んですぐ書き始める | 内部で下書きしてから書き始める |
| 返ってくるまでの時間 | 短い | 長くなりやすい |
| トークンの増え方 | 答えの分だけ | 答え+見えない思考の分 |
| 得意なこと | 要約・翻訳・整形・分類 | 数学・プログラミング・多段階の分析 |
| 向かない場面 | 手数の多い難問 | 速さや安さを優先したい単純作業 |
賢い・賢くないの差ではなく、答え方そのものが違うと思ってください。用途が合っていないと、ただ遅いだけになります。
ここまでで押さえておきたいのは1点だけです。推論モデルを選ぶことは上位グレードを選ぶことではなく、待ち時間とトークンを差し出して答えの質を買う、という取引を選ぶことにあたります。
なぜ遅くて上限の減りが早い?答えの前に生まれる「思考トークン」
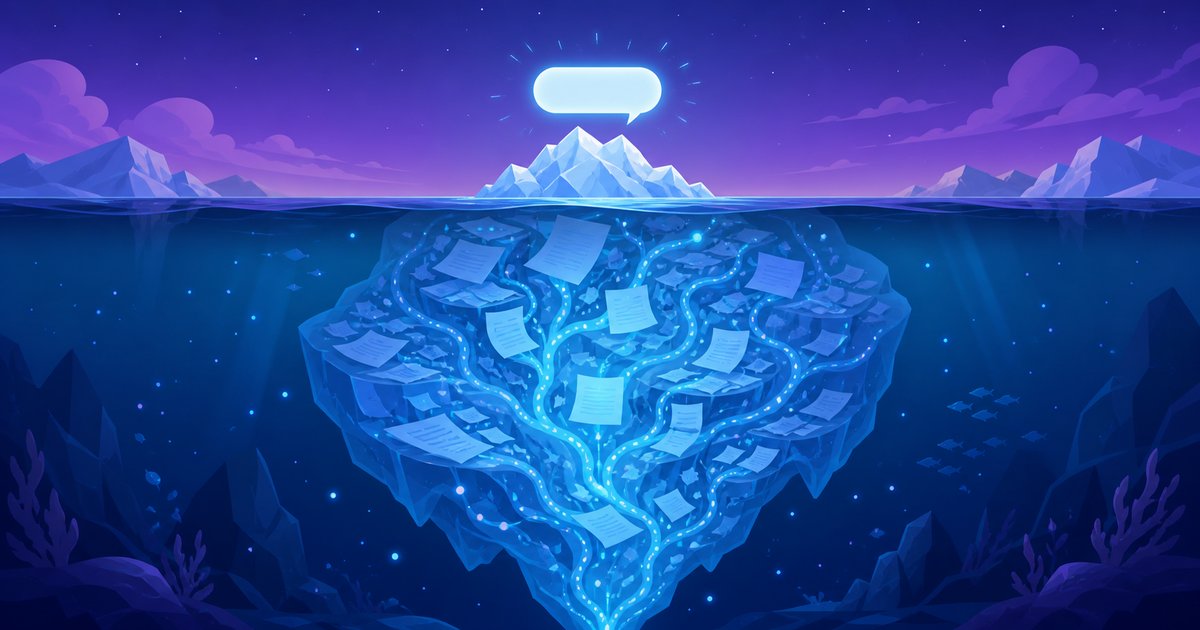
よくある疑問:短い答えしか返ってきていないのに、どうして上限の減りが早い気がするの?
その体感の背景にあるのは思考トークン(=答えを書く前にAIが内部で書き出す下書きのようなもの)です。ここは3社の公式ドキュメントの説明がきれいに揃っている部分です。
OpenAIの開発者向けドキュメントは、推論トークンについて「APIからは見えないが、モデルのコンテキストウィンドウの領域を占有し、出力トークンとして課金される」と明記しています(2026年9月2日確認)。
同じページには使用量の実例も載っていて、出力トークン1,186のうち1,024が推論トークンという内訳が示されています。読める文章はごく短くても、請求上は1,186トークン分が発生している計算になります。
GoogleのGemini APIドキュメントも「思考をオンにすると、応答の料金は出力トークンと思考トークンの合計になる」と書いています。Anthropicの公式ドキュメントも同様で、推論に使ったトークンは、その思考テキストが返ってこない場合でも出力トークンとして課金される、としています。
つまり推論モデルでは、返ってきた文章の長さが、支払っている量の目安になりません。料金の考え方そのものは普通のモデルと同じなので、仕組みから知りたい方はAIのトークンとは?料金が決まる仕組みと節約のコツもあわせてご覧ください。
ひとつ補足すると、ここまでの課金の説明は各社が開発者向けに公開している仕組みの話です。チャットアプリの無料枠や利用回数がどう数えられているかは各サービスの案内によるため、減り方が同じとは限りません。
会話が長くなると、思考の分だけ席が埋まる
もうひとつ見落としやすいのが場所の問題です。OpenAIの説明どおり、思考トークンはコンテキストウィンドウ、つまりAIが一度に見ていられる範囲を占有します。
同ドキュメントは、問題の複雑さによって推論トークンは数百から数万にまで達すると述べ、使い始めのうちは推論と出力のために少なくとも25,000トークン分の空きを確保しておくよう案内しています。
Anthropicのドキュメントでも、思考トークンは応答の上限に数え入れられると書かれています。
空きが足りないまま走らせると何が起きるかも書かれています。OpenAIによれば、上限に達した応答は未完了の状態で返り、目に見える出力が1文字も出ないまま、入力と推論の分だけ費用が発生することがあります。
長い会話の途中で急に前の話を忘れたように見えるときも、思考の分まで含めて範囲を使い切っている可能性があります。この仕組み自体はコンテキストウィンドウとは?AIが前の会話を忘れる理由で詳しく解説しています。
ここでの結論はシンプルです。返事が遅い・上限の減りが早いと感じたら、それは不具合ではなく深く考えさせている状態だと判断してよく、急ぎの用件なら考える量を下げるか即答型に切り替えるほうが結果として早く済みます。
画面に出る「思考」は本物?見えているのは要約です
推論モデルを使っていると、答えの前に思考の途中経過らしきテキストが流れることがあります。あれを読んで「AIの本音が見えた」と感じる方は多いのですが、実際に届いているのは要約です。
AnthropicのThinkingの解説ページは、表示されるテキストについて「あなたが見るものは決して生の思考の連なりではなく、思考ブロックのテキストはClaudeの推論の要約である」と述べています。
さらに、どの表示設定を選んでも生の思考は返らないとも明記されています(2026年9月2日確認)。同ページによれば、多くのモデルでは要約を返さない設定が既定で、表示を指定して初めて要約が返ります。
理由も書かれていて、要約という形にすることで思考による性能の利点は保ちつつ、悪用を防ぐためだとしています。
同じ箇所には課金の注意もあり、請求されるのは元のリクエストが生成した思考トークンの全量で、要約のトークン数とは一致しないとはっきり書かれています。
表示される思考は仕組みを覗く手がかりであって、支払った量の証拠にも、検証できる記録にもなりません。
Gemini側の説明も重なります。公式ドキュメントは、既定では最終的な出力だけが返り、思考の要約は設定を有効にしたときに受け取れるものだと説明したうえで、「料金はモデルが生成する必要のあった思考トークンの全量に基づく。
APIから出るのが要約だけであっても同じ」としています。要約が空になる場合も明示されていて、質問が単純でモデルが十分に推論しなかったとき、要約を出さない設定にしているとき、画像のように要約になじまない内容のときが挙げられています。
この2つを並べると、表示が短いことは「あまり考えていない」ことを意味しないのが見えてきます。見えている量と実際に考えた量は、そもそも別のものとして扱われています。
画面に流れた思考の中身を、そのまま事実として引用しないでください。要約である以上、途中で捨てた案や検討中の仮定が含まれていることがあります。
思考を挟んでも誤りが起きる点は変わらないので、事実確認の考え方はAIのハルシネーションとは?原因・見抜き方・安全な使い方を参考にしてください。
思考の表示は「今こういう方向で進んでいる」を知る目安として眺めるくらいが、ちょうどよい距離感になります。
推論モデルを使うべき場面・使わない方がいい場面
各社とも、考える量は固定ではなく調整できるようになっています。ただし呼び名も段階の数もばらばらなので、まず横並びで整理します。
| 比べる軸 | OpenAI | Google(Gemini) | Anthropic(Claude) |
|---|---|---|---|
| 思考の呼び名 | 推論トークン | 思考トークン | 思考(thinking) |
| 深さの指定 | reasoning effort | thinking_level | effort(自動判断が前提) |
| 段階 | none / minimal / low / medium / high / xhigh / max(対応する値はモデルによって異なる) | minimal / low / medium / high(対応レベルはモデルにより異なる) | low / medium / high / xhigh / max(既定はhigh) |
| 既定の動き | モデルごとに既定値が違う。難易度に応じて使う量を自動調整 | 既定は動的思考。要求の複雑さに応じて自動調整 | 思考するかどうかをモデルが毎回判断。しない回もある |
| 思考の見え方 | APIからは見えない | 既定は非表示。設定すると要約を取得(空のこともある) | 返るのは要約のみ。生の思考は返らない |
| 課金の扱い | 出力トークンとして課金 | 出力トークン+思考トークンの合計 | 思考が返らなくても出力トークンとして課金 |
表の内容は、いずれも2026年9月2日に各社の公式ドキュメントで確認した記載です。3社に共通しているのは、段階を手で刻むより先に、モデル側の自動判断が既定になっている点です。
なお、ここに出てくるのは開発者向けの設定名なので、チャットアプリの画面上の表示名とは一致しません。アプリの表示名とAPIのモデル名を同じものとして扱わないよう注意してください。
向いている作業と、深く考えさせても報われない作業
Geminiの公式ドキュメントは使い分けの目安をはっきり書いています。
事実の調べものや分類のような単純な作業は最小限か浅めの思考で十分、概念の比較や創造的な思考を伴う作業は既定のまま、高度なコーディング・数学・多段階の計画には最大限の思考を、という整理です。
長い出力を求めるときは、むしろ思考を減らすよう指示してトークンを節約する、という助言も添えられています。
- 深く考えさせたい:プログラムのバグ探し、計算や検算、条件が絡み合う計画づくり、長い資料の突き合わせ
- 浅くていい:要約、翻訳、言い換え、表への整形、分類、定型的な文面の作成
- 判断が割れる:文章の推敲や企画出し。速さ優先なら即答型、詰めたいときだけ深く
よくある疑問:迷ったら、いつも一番深く考えさせる設定にしておけばいいのでは?
そうとも言い切れません。OpenAIのドキュメントは「低い設定は速度とトークン消費の少なさを優先し、高い設定ではモデルがより十分に考えて質の高い応答を返す」と説明しており、速さと質のどちらを取るかという交換条件であることを明確にしています。
最上位に近いxhighについては「追加の遅延と費用に見合う明確な利点が評価で確認できたときだけ使う」とまで書かれています。
Anthropicの拡張思考のドキュメントにも、思考の予算を増やせばより網羅的な推論ができるものの、収穫は逓減し、そのぶん待ち時間が伸びるという趣旨の記載があります(2026年9月2日確認)。
同ページでは思考予算の下限が1,024トークン、32,000トークンを超える予算は通信が長引くためバッチ処理を使うよう案内されており、深くすれば無限に良くなる話ではないことが数字でも示されています。
「考えるかどうか」をモデル自身が決める流れ
設定に悩まなくて済む方向へは、はっきり進んでいます。
Anthropicの場合、リクエストごとに考えるかどうかと深さをモデル自身が決める適応的思考(adaptive thinking)が標準の形になり、開発者が思考量を数値で指定していた従来の拡張思考は新しい世代のモデルでは受け付けられなくなりました(同ドキュメント、2026年9月2日確認)。
手で刻む運用から、意図を伝えて任せる運用へ切り替わったわけです。
あわせて、簡単な質問に対してモデルが思考を省略した場合は思考ブロック自体が作られない、とも明記されています。
Geminiも既定は動的思考で、要求の複雑さに応じて推論の量を自動で調整すると書かれており、ChatGPTにも前述の自動切り替えがあります。思考の表示が出ない回があっても、故障や手抜きではありません。
読者としての現実的な結論はこうなります。普段は自動または既定に任せ、答えが浅いと感じたときだけ深く考えるモデルに切り替える。この二層構えなら、毎回モデル名を見比べる必要はありません。
自分のPCで推論モデルを動かすなら?速さとメモリの考え方
推論モデルはクラウド専用の技術ではありません。手元のパソコンで動かせる公開モデルにも、考えてから答えるタイプがあります。
たとえばOllamaの公式ライブラリでは、DeepSeek-R1が「オープンな推論モデルのファミリー」と紹介されています(2026年9月2日確認)。同じページにサイズ別のタグが並んでいて、タグを付けずに実行したときの既定は8b、扱えるコンテキストは128K(671bのみ160K)と記載されています。
| タグ(規模) | ダウンロードサイズ | だいたいの位置づけ(目安) |
|---|---|---|
| 1.5b | 1.1GB | とりあえず動かして試す用 |
| 7b / 8b | 4.7GB / 5.2GB | 個人のPCで現実的に扱いやすい範囲(8bが既定) |
| 14b | 9.0GB | 余裕のあるGPUがほしくなる規模 |
| 32b | 20GB | VRAMの多い環境向け |
| 70b / 671b | 43GB / 404GB | 個人の環境では現実的でない規模 |
タグとサイズはOllama公式の掲載値(2026年9月2日確認。前回2026年8月24日の確認時から変更なし)で、右端の位置づけは扱いやすさの目安です。
ここに書いたのはあくまでモデル本体の容量で、必要なメモリやVRAMの量そのものではありません。実際に必要な量は量子化(=モデルを軽くする圧縮のやり方)や設定でも変わるため、目安として見てください。
推論モデル特有の、2つの注意点
1つめは生成の速さです。推論モデルは答えの前に思考トークンを作るため、普通のチャットより生成量そのものが増えます。
1秒あたりに書き出せる量が少ない環境では、待ち時間の伸び方が体感に直結しやすくなります。クラウドで数百から数万トークンの推論が走る作業を、そのまま手元に持ってくると差が開きます。
2つめは余裕を持ったメモリの確保です。思考トークンはコンテキストを占有するので、モデル本体が載るだけでは足りません。会話が長くなる使い方をするなら、その分の空きを見込んでおく必要があります。
モデルの規模ごとのVRAMの目安はローカルLLMに必要なVRAMは何GB?モデル別の目安とGPUの選び方で整理しています。手持ちのPCで足りるかを判断したいときは、そちらから逆算するのが手早く済みます。
ローカルで長く考えさせたいなら、まず見るべきはGPUのVRAM容量です。ここが足りないと、快適さを比べる段階まで進めません。
\AI時代の相棒探し/
まとめ
- 推論モデル(Thinking)=答える前に内部で下書きのように考えてから返すモデル
- 遅さと上限の減りの正体は思考トークン。見えなくても出力トークンとして課金される(OpenAIの実例では出力1,186トークンのうち1,024が推論分)
- 画面に出る思考は要約。生の思考は返らず、課金は生成された全量が対象なので、そのまま事実として引用しない
- 数学・プログラミング・多段階の分析は深く、要約や翻訳は浅く。収穫は逓減するため、深くするほど良いわけではない
- 深さの指定は3社とも自動判断が既定。まず任せて、物足りないときだけ手動で上げる
- 手元のPCでも動かせる。本体+思考の分の余裕が載るかと、生成の速さが体感を左右する
推論モデルは、上位グレードのAIではありません。時間とトークンを払って精度を買うモードだと捉えると、選び方も設定も迷わなくなります。速さが要る場面まで深く考えさせても、得られるものより失う時間のほうが大きくなります。
次の一歩は2つに分かれます。日常の用途が中心なら、即答型と自動切り替えに任せて、答えが浅いと感じたときだけ深いモードへ。プログラミングや長い分析が中心なら、はじめから深く考えるモデルを選び、待ち時間とトークンの増加を織り込んで使う。
どちらの場合も、料金やプランは変わりやすい部分です。本記事の記載は2026年9月2日に確認した内容なので、最新の条件は各社の公式サイトで確かめてください。
- 推論モデルは普通のモデルより必ず賢いのですか?
-
用途によります。数学やプログラミング、条件の多い分析では有利ですが、要約・翻訳・整形のような作業では、待ち時間とトークンが増えるだけになりがちです。Geminiの公式ドキュメントも、単純な作業には浅い思考、高度なコーディングや数学には深い思考、という使い分けを示しています(2026年9月2日確認)。
- AIの思考の中身は全部見られますか?
-
見られません。Anthropicの公式ドキュメントには、表示されるのは推論の要約であり、どの表示設定でも生の思考の連なりは返らないと明記されています。多くのモデルでは要約を返さない設定が既定で、表示を指定して初めて返ります。
要約にしている理由は、思考による性能の利点を保ちながら悪用を防ぐためとされています。
- 推論モデルを使うと料金や上限の消費は増えますか?
-
仕組みのうえでは増えます。
OpenAI・Google・Anthropicのいずれも、思考に使ったトークンは出力トークンとして課金されると説明しており、GoogleとAnthropicは要約しか返らない場合でも生成された思考トークンの全量が対象だとしています。
OpenAIのドキュメントには、上限に達すると目に見える出力が返らないまま費用だけ発生する場合がある、という注意もあります。具体的な単価や無料枠は変動するため、最新は各社の公式サイトで確認してください。
- 自分のパソコンでも推論モデルは動かせますか?
-
動かせます。Ollamaの公式ライブラリには、オープンな推論モデルのファミリーとしてDeepSeek-R1が掲載され、1.5b(1.1GB)から671b(404GB)までサイズ別のタグが並んでいます(2026年9月2日確認)。
判断の目安は、モデル本体に加えて思考トークンを含むやり取りの分まで、メモリやVRAMに載せられるかどうかです。
- どのモデルを選べばいいか分かりません。
-
自動に任せて構いません。Anthropicの適応的思考のように、いつどれくらい考えるかをモデル自身が判断する方式が標準になりつつあり、Geminiの既定も動的思考、ChatGPTには自動切り替えが用意されていると報じられています。
答えが浅いと感じたときだけ、手動で深いモードに切り替えるのが手軽な運用です。
関連記事