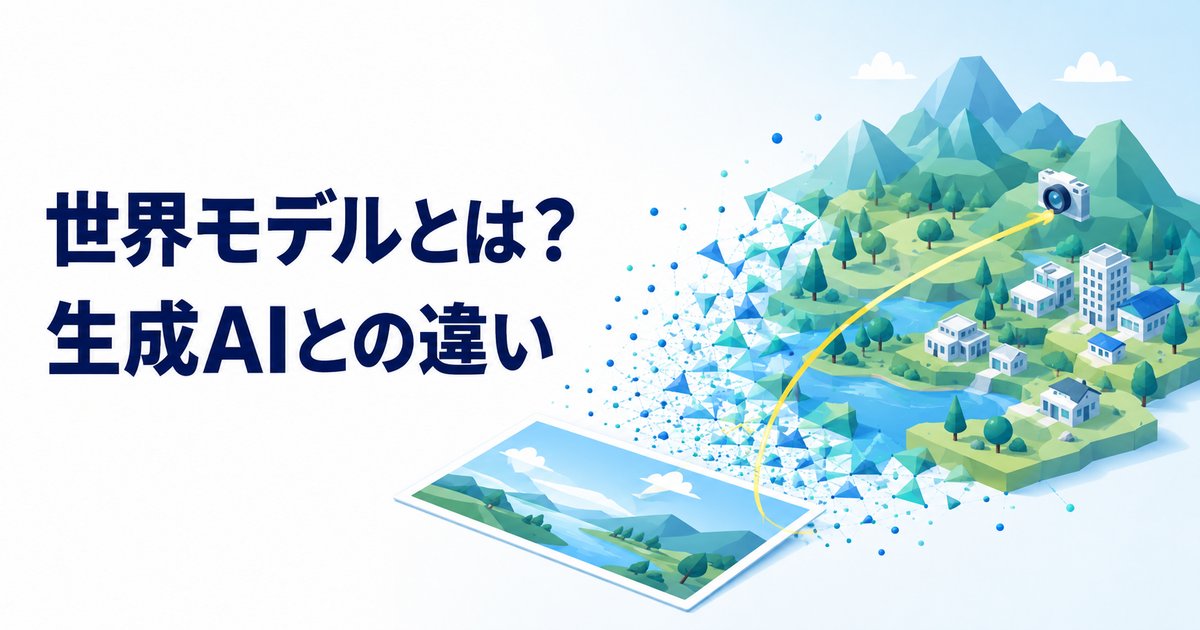
世界モデルとは、AIが映像や3Dのデータから空間の成り立ちを学び、次に何が起きるかを予測する技術です。2026年に入って、この言葉を見かける機会が一気に増えました。
文章を作るAI、絵を作るAIときて、次に来ると言われているのがこれです。作るのは文章ではなく、中を動き回れる空間そのものだと説明されています。
ただ、日本語の解説は企業向けの導入話が中心で、「結局どういう技術なのか」「自分のPCで動かせるのか」までは書かれていません。
そこでこの記事では、公式が公表している内容だけを2026年9月8日に確認して並べました。数字には出典と確認日を添えています。
- 世界モデルとは、空間と時間の続きを予測するAIのことです
- 世界モデルは環境の構造や変化を扱う。画像・動画を作る生成AIとも技術が重なる
- 2026年9月時点で誰でも試せるのはWorld LabsのMarble(無料枠あり)
- 掲載するCosmos-Predict2の要件は26.02GB以上。世界モデル全般の最低容量ではない
- 今すぐPCを買う必要はなく、AI用途で見るべき軸はVRAMの容量です
世界モデルとは?生成AIとの違いを結論から先に
世界モデルは、環境の構造や変化を表現し、次に起こることを予測・生成するモデルです。生成AIと完全に別の技術ではなく、映像を作る方式と重なる部分があります。入力・出力や操作できる範囲はモデルごとに確認します。
英語ではWorld Model(=日本語ではワールドモデルとも呼ばれます)。ここではサイト内の表記を「世界モデル」でそろえます。
World LabsのAtlas解説は、自己回帰と拡散を組み合わせたモデルで、LLMと同様に入力を文脈へまとめると説明しています。世界モデルと生成AIの技術が重なる具体例です(2026年9月22日確認)。
先に誤解をひとつ解いておきます。ここでいう「世界」は地球でも規模の話でもありません。AIが頭の中に持っている環境という意味です。
| 比べる点 | 文章・画像生成の一般的な利用例 | この記事で扱う世界モデルの例 |
|---|---|---|
| 予測するもの | 言葉や絵の続き | 空間と時間の続き |
| 主な入力 | 文章・画像 | 映像・3Dデータ・カメラの動き |
| 主な出力 | 文章・画像・動画 | 立体データ、視点を動かせる映像 |
| 読者の使い方 | ブラウザで文章や絵を作る | 空間を作り、その中を見て回る |
| 2026年9月時点の入手性 | 無料でも選択肢が多い | 一般提供は一部にとどまる |
文章生成と世界モデルは、何を表現・予測するかが違う
文章を作るAIは、膨大な文章から「この言葉の次に来やすい言葉」を学びます。だから会話も要約もこなせます。
いっぽう世界モデルは、映像や立体のデータを読んで「この場面の次に来る場面」を学びます。学ぶ材料が違えば、できることも変わります。
見た目が似た動画でも、操作に応じて続きを生成するのか、3Dデータを書き出せるのかで使い道が変わります。生成AIと世界モデルを、互いに重ならない分類として扱わないことが大切です。
なぜ3Dやカメラの動きが出てくるのか
AtlasやMarbleは、映像に加えて立体データを扱う例です。ただし、すべての世界モデルが3Dファイルを出力するわけではありません。画面内を操作できることと、編集用の立体データを取り出せることを分けて確認します。
World Labsが2026年9月1日に公式ブログで発表したAtlasは、新しい視点の映像に加えて点群(=立体を細かい点の集まりで表したデータ)や3D Gaussian splatsを出力すると説明しています。
同社のMarbleも、作った空間をメッシュや動画として書き出せます。絵を描いているのではなく、空間を組み立てているわけです。
世界モデルの仕組み|見る・覚える・次を予測するの3段階
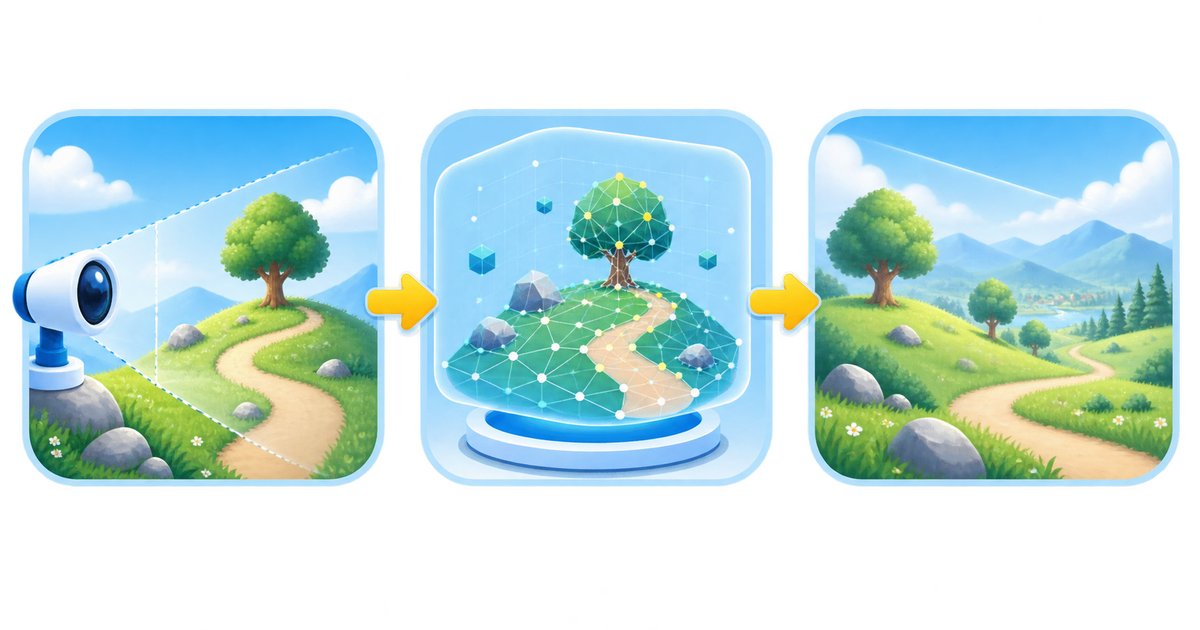
世界モデルの中身は、大きく3つの段階に分けて考えると追いやすくなります。
世界モデルが踏む3つの段階
- 見る:映像・画像・立体のデータから、今の場面を受け取る
- 覚える:受け取った情報を、内部の状態としてまとめて持つ
- 予測する:その状態をもとに、次に来る場面を作り出す
人がボールを投げれば落ちると分かるのは、頭の中に物の動き方の見取り図があるからです。世界モデルは、それを機械にやらせようとしています。
だから入力も、文章だけでは足りません。Atlasの公式ブログは、テキスト・画像・動画・3Dデータに加えて、カメラの位置や向きまで受け取ると書いています。
Atlasが空間の文脈を保つ仕組み
場面の続きを自然につなぐには、見えていた物体や位置関係との整合が必要です。Atlasは入力を共通の空間的な文脈へまとめますが、内部状態の有無だけで生成AI全般と区別できるわけではありません。
Atlasはこの点を、すべての入力をひとつの共有された空間的な文脈にまとめる構造だと説明しています(2026年9月1日の公式ブログ、2026年9月8日確認)。
Atlasでは、共有した空間の文脈を条件に、別の視点の画像や映像を生成すると説明されています。これはAtlasの説明であり、すべての世界モデルの内部構造を示すものではありません。
むずかしく見えますが、要するに「見た場面を覚えておいて、その続きを描く」だけです。
世界モデルは何に使われる?期待される用途と現状の課題
ここまでの仕組みが、どんな場面で役に立つと考えられているのかを整理します。
期待されている用途
立体データを必要とする分野として、Atlasの公式ブログはロボット工学・ゲーム・デザイン・VFXを挙げています(2026年9月8日確認)。
- ロボットや自動運転:動き出す前に、次に何が起きるかを内部で試せる
- ゲームや映像の制作:舞台になる空間そのものを素材として組み立てられる
- 設備や作業の検討:実物をそろえる前に、配置や動線を空間で確かめられる
どれも「先に起きることを知っておきたい」場面です。世界モデルが予測するのは空間と時間なので、こうした用途とかみ合います。
メリットは実物で試す前に確かめられること
実物で試すのは、時間もお金もかかります。危ない場面なら、壊れたり事故になったりもします。
そのコストを仮想の空間で肩代わりできる点が、世界モデルにいちばん期待されているところです。
何度でもやり直せますし、試す回数を増やせること自体が価値になります。
課題は予測のズレと、必要な計算資源の大きさ
ひとつめは、作られた空間と実際の環境がずれることです。もっともらしく見えても、そのまま実物に当てはまるとは限りません。
続けられる長さにも限りがあります。Genie 3の公式ブログには、支えられるのは数分の連続操作で長時間ではないと明記されています(2025年8月5日の発表時点)。
もうひとつが計算資源の大きさです。どれだけの容量が要るのかは、次の章で公式の数値をそのまま見ていきます。
いま注目されている世界モデル4つ|Atlas・Marble・Genie 3・Cosmos
ここからは、公式が情報を出している世界モデルを4つ見ていきます。提供状況はいずれも下の表の時点のもので、2026年9月8日に公式ページで確認しました。
| 世界モデル | 開発元 | できること | 確認時点の提供状況 |
|---|---|---|---|
| Atlas | World Labs | テキスト・画像・動画・3Dをまとめて扱い、映像と立体データを出す | 2026年9月1日の発表時点で一部パートナー向けのアーリーアクセス |
| Marble | World Labs | テキストや画像から3D空間を作り、書き出せる | 2026年9月8日時点で一般提供中 |
| Genie 3 | Google DeepMind | 作った空間の中をリアルタイムに移動できる | 2025年8月5日の発表時点で限定リサーチプレビュー |
| Cosmos | NVIDIA | 映像から次の場面を予測する。必要VRAMを公式が公開 | Hugging Faceでモデルが配布されている |
World Labs「Atlas」|1440pで最長1分、カメラの動きも指定できる
Atlasは、テキスト・画像・動画・3Dを最初からひとまとめに扱うために一から学習させたモデルだと公式ブログに書かれています。
生成できるのは1440pで最長1分の映像。あわせて点群や3D Gaussian splatsといった立体データも出力します。
特徴的なのがカメラの扱いです。「右に振って」と文章で頼むのではなく、カメラの位置や向きを幾何的な入力としてそのまま渡せると説明されています。
World Labsが公表した評価結果も載っています。カメラを指定して作った映像は、第三者の評価者による選好率が比較対象に対して75〜94%だったとのこと。
少ない視点から立体を復元する誤差の指標も、Atlasが25.3、比較対象は28.7以上(小さいほど誤差が少ない)と示されています。
ただしこれは同社が自社で公表した数値なので、「最も高性能」と読み替えるのは早すぎます。提供は一部パートナー向けで、料金も必要スペックも公開されていません。
World Labs「Marble」|今日ブラウザで試せるのはここ
同じWorld Labsが2025年11月12日に公開したMarbleは、2026年9月8日時点で一般提供中の世界モデルです。この記事で紹介する中で、今すぐ触れるのはこれだけです。
入力はテキスト・画像・動画・おおまかな3Dレイアウト。作った空間はGaussian splats、メッシュ、動画として書き出せます。
プランはFree・Standard・Pro・Maxの4種類で、生成できるワールドの数が変わります。公式ドキュメントの記載では、Freeが最大4回、Standardが12回、Proが25回、Maxが75回です(2026年9月8日確認)。
金額はこのドキュメントに記載がないため、ここでは触れません。料金は変わりやすいので、公式の料金ページで確認してください。
Google DeepMind「Genie 3」|720p・24fpsで歩き回れる
Genie 3は、テキストから作った空間の中をリアルタイムに移動できる世界モデルです。公式ブログには720p・24フレーム毎秒と書かれています。
一貫性が保たれるのは数分間で、視覚的な記憶はおおよそ1分前までさかのぼれるとのこと。長時間ではなく数分の連続操作を支える段階だと明記されています。
提供は限定リサーチプレビューで、研究者やクリエイターの少人数に早期アクセスを出している状態です。これはいずれも2025年8月5日の公式発表時点の説明で、その後の公開範囲は公式に確認できていません。
NVIDIA「Cosmos」|自分の手元に持ってこられる唯一の例
Cosmosは、映像から次の場面を予測する世界モデルの集まりで、モデル本体がHugging Faceのnvidia配下で配布されています。
つまり、4つのうち自分のPCへ持ってこられる形になっているのはCosmosだけです。入手先についてはHugging Faceとは?AIモデルの入手先と自分のPCで動かす方法も参考になります。
ライセンス条件は公式ドキュメントの表に書かれていません。使う前に配布ページの記載を必ず読んでください。
世界モデルは自分のPCで動かせる?公式のVRAM要件で確かめる
ここは数字で答えが出ます。まずは必要な容量と、手元にある容量を並べてみます。
※上の4つはNVIDIA公式ドキュメントの記載値(2026年9月8日確認)。下の3つは、ゲーミングPCでよく見かける容量です。
よくある疑問:世界モデルって、うちのゲーミングPCでも動かせるの?
公式が示す必要VRAMは26.02〜56.38GB
NVIDIAの公式ドキュメントには、Cosmos-Predict2の各モデルについて「Required GPU VRAM」という列で必要な容量が書かれています。
| モデル名 | パラメータ数 | 必要なVRAM |
|---|---|---|
| Cosmos-Predict2-2B-Text2Image | 2B | 26.02 GB |
| Cosmos-Predict2-2B-Video2World | 2B | 32.54 GB |
| Cosmos-Predict2-14B-Text2Image | 14B | 48.93 GB |
| Cosmos-Predict2-14B-Video2World | 14B | 56.38 GB |
末尾の2Bや14Bは、モデルの規模を表す数字です。数が大きいほど中身が重くなり、必要な容量も増えます。
同じ表には(OOM)という表記も出てきます。これはOut of Memory(=メモリが足りず処理が始められない状態)の略で、そのGPUでは大きすぎて動かないという意味です。
よくあるゲーミングPCのVRAMとの差
いま販売されているゲーミングPCで、よく見かけるVRAM(=グラフィックボードに載っているメモリ)の容量は8GB・12GB・16GBあたりです。
この比較でVRAM 8GB・12GB・16GBが届かないのは、表に掲載したCosmos-Predict2の要件です。すべての世界モデルが家庭用PCで動かない、という結論にはできません。使いたいモデルと実行方法ごとに確認しましょう。
画像生成でも世界モデルでも、必要なメモリが不足すると読み込みや生成に失敗する場合があります。調整や省メモリ機能が使えるかは実装次第なので、モデルの案内で対応する方法を確認してください。
公式の720p・対応GPUの制約は、NATTENを使うVideo2Worldの高速化方式についての説明です。Cosmos全体で設定変更ができないという意味ではなく、使うモデルと機能の条件を分けて読みます。
それでもPC選びでVRAMを見るべき理由
ここは正直に書きます。世界モデルのために今すぐPCを買う必要はありません。2026年9月時点では、ブラウザで体験する時期だからです。
ただしAI用途全般で見ると、VRAMの容量は「動く・動かない」をそのまま決める部分です。画像を作るAIも、映像を作るAIも、手元で動かす言語モデルも同じ軸で判断できます。
容量ごとの目安はローカルLLMに必要なVRAMは何GB?モデル別の目安とGPUの選び方と動画生成AIをローカルで動かすには?必要なVRAMとPCスペックを解説で整理しています。
GPUの名前だけでなく、スペック欄の容量表記まで見ておくと安心です。
\AI時代の相棒探し/
※価格・在庫は変動します。最新は公式で確認してください。
今日から世界モデルを試すなら|ブラウザで動くMarbleの始め方
手元のPCで動かせなくても、体験は今日できます。一般提供中のMarbleなら、ブラウザだけで世界モデルの出力に触れられます。出てくるのは1本の映像ではなく、見て回れる空間です。
World Labsの公式サイトからMarbleのページへ進みます。検索結果の非公式なまとめサイトからではなく、公式のドメインから入ってください。
公式ドキュメントによると、Freeは「テキストのプロンプト、1枚の画像、または360度パノラマからワールドを生成できる」入門用のプランです。
まずはテキストだけで試すのが手軽です。作りたい場所の様子を短い文で書けば、その空間が組み上がります。
Freeで生成できるワールドは最大4回までと記載されています(2026年9月8日確認)。公式は各プランを月ごとの割り当てとして説明しています。
枠は限られているので、入力を練ってから実行すると無駄がありません。
作ったものを仕事に使う場合は、着手する前に商用利用の条件を公式で必ず確認してください。公式ドキュメントで生成物の商用利用の権利が明記されているのはProプランです(2026年9月8日確認)。
無料枠の生成は4回までなので、作りたい場所を決めてから触るのがおすすめです。
まとめ|世界モデルとの付き合い方
新しい技術ですが、やることの順番はそれほど複雑ではありません。
- まずMarbleの無料枠で、世界モデルの出力を実際に見てみる
- 手元で実行する前に、モデル名・版・実行方法ごとのメモリ要件を確認する
- 提供状況は動くので、料金と条件は必ず公式の最新表示で確認する
- PCを選ぶなら、世界モデルではなく日常のAI用途を基準にVRAMを見る
- 評価の数値は誰が測ったものかまで見て、うのみにしない
言葉だけでなく空間そのものを扱う方向として注目されている分野なので、AGI(汎用人工知能)とは?今のAIと何が違う?Astraとの関係も解説とあわせて読むと流れがつかみやすくなります。
世界モデルは、まだ「見に行く」段階の技術です。急いで機材をそろえるより、無料で触れる範囲から慣れておくほうが、判断を誤りにくいはずです。
- 世界モデルと生成AIは何が違うのですか?
-
世界モデルは環境の構造や変化を表現・予測することに重点を置きます。生成AIと重なる技術で、必ず3Dデータを出力するわけではありません。Atlasの立体出力とGenie 3の対話可能な映像など、モデルごとの機能を見てください。
- 世界モデルは無料で試せますか?
-
World LabsのMarbleにFreeプランがあり、最大4回までワールドを生成できます(2026年9月8日に公式ドキュメントで確認)。金額や条件は変わるため、最新は公式サイトで確認してください。
- 自分のゲーミングPCで世界モデルは動きますか?
-
モデルと実行方法によります。この記事のCosmos-Predict2表では必要VRAMが26.02〜56.38GBで、8〜16GBでは表の要件に届きません。この数値は世界モデル全般の最低容量ではないため、使いたい版の公式要件を確認してください。
- 世界モデルがあればゲームが自動で作れるようになりますか?
-
公式の説明はそこまで踏み込んでいません。Genie 3は数分の連続操作を支える段階だと明記されており、2026年9月時点では制作を丸ごと置き換える話にはなっていません。
- 世界モデルはAGIとつながる技術ですか?
-
Google DeepMindはGenie 3をAGIへ向けた研究で重要な技術と位置付けています。ただし、世界モデルがあることだけでAGIの達成や実用性が証明されるわけではありません。開発元の目標と、現在確認できる機能は分けて読みましょう。